
El coste territorial del SEO/GEO: luz, agua y paisaje detrás de cada búsqueda con IA
A dos horas en coche de donde se escribe este texto está la Ribera d’Ebre. Allí, en Móra la Nova, un consorcio liderado por ACS, Telefónica y Banco Santander arrancará en 2028 una gigafactoría de inteligencia artificial que empezará consumiendo entre 30 y 55 MW y podrá llegar a 100-125 MW de potencia conectada. Es el equivalente, en orden de magnitud, al consumo eléctrico de una ciudad mediana catalana.
En Aragón, los más de treinta centros de datos proyectados por Amazon, Microsoft, Blackstone, Azora y otros sumarían, según estimaciones citadas por Público, unos 55.000 GWh de consumo anual: cinco veces lo que hoy consume toda la comunidad autónoma, más que Catalunya entera en 2024. La inversión comprometida ronda los 47.000 millones de euros.
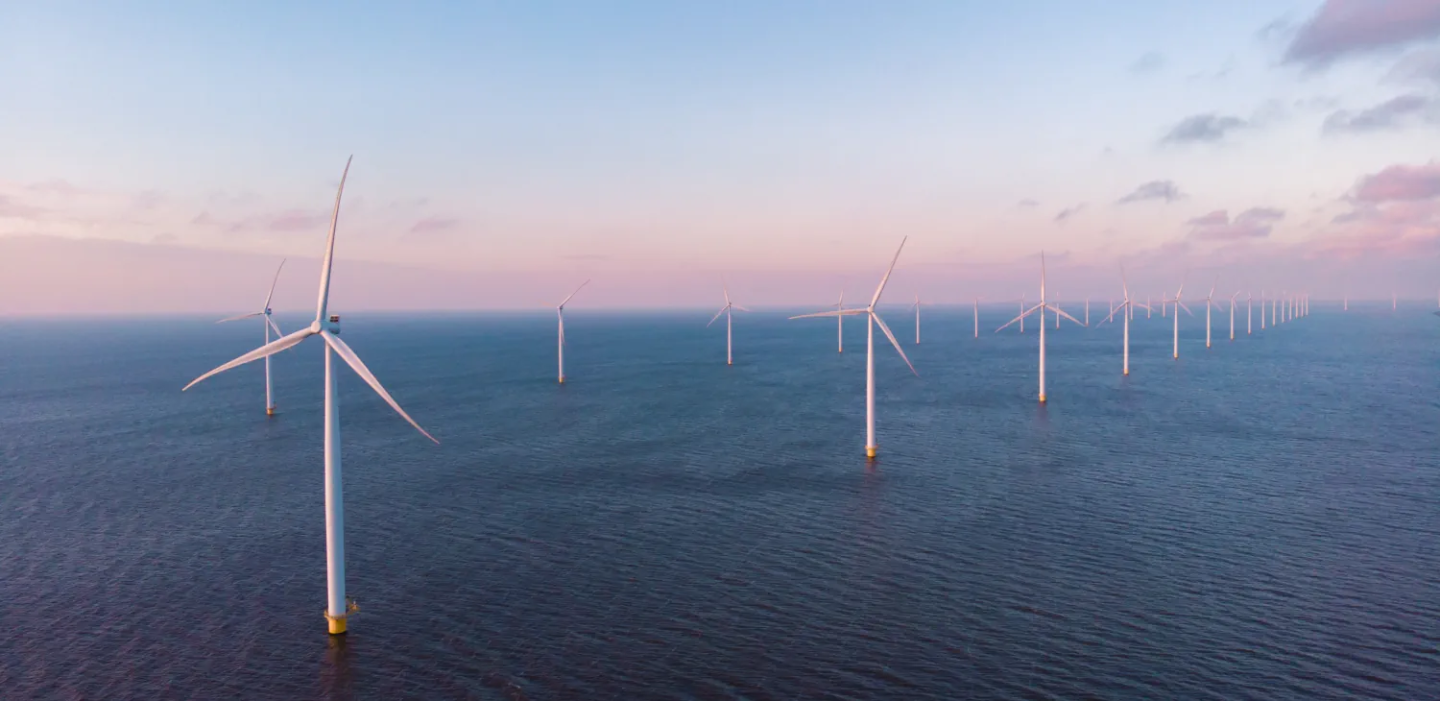
En la Costa Brava, el Ministerio para la Transición Ecológica autorizó en junio de 2026 el proyecto Plemcat de tres aerogeneradores flotantes de 15 MW frente al Golfo de Roses, con oposición municipal frontal en l’Escala, l’Estartit y el resto de ayuntamientos del Empordà afectados.
Estas tres instantáneas no son titulares desconectados. Son la cara física de un mismo fenómeno: la economía de la búsqueda con inteligencia artificial. Un fenómeno que tiene coordenadas geográficas, factura eléctrica y consumo de agua. Y que, de forma menos evidente pero igualmente directa, redefine la práctica profesional del SEO y de lo que empieza a llamarse GEO (Generative Engine Optimization, en mi opinión una evolución del SEO, que sigue siendo «SEO»).
El multiplicador invisible: query fan-out
Hasta hace poco, una consulta en un buscador era una petición. Hoy, los sistemas de búsqueda con IA aplican la técnica del query fan-out. Google la describe con precisión en la documentación de AI Mode: descompone la pregunta en subtemas y lanza una multitud de consultas en paralelo para construir una respuesta sintética y completa. En Deep Search, la variante profunda, pueden ser cientos de sub-consultas por cada pregunta formulada por el usuario.

El efecto en la demanda de cómputo es inmediato. El informe ambiental de Google publicado en junio de 2026 reporta un incremento del 37% en consumo eléctrico, del 18% en emisiones y del 34% en agua respecto al año anterior. Es el mayor salto anual de emisiones que ha publicado la compañía, y lo justifica principalmente por la expansión de infraestructura y la fabricación de hardware para IA. La eficiencia por consulta mejora (Google cifra el prompt mediano de Gemini en 0,24 Wh y una mejora de eficiencia de 33x en doce meses), pero el volumen agregado crece más rápido. Efecto rebote clásico.
A escala global, la Agencia Internacional de la Energía proyecta que el consumo eléctrico de los centros de datos pase de los 415 TWh de 2024 (en torno al 1,5% del total mundial) a unos 945 TWh en 2030. Los servidores aceleradores, los que soportan carga de IA, explican casi la mitad del incremento neto. Para Europa se prevé un aumento de 45 TWh (+70%).
En España, el informe anual de SpainDC proyecta inversiones por 66.900 millones de euros hasta 2030 y un salto de capacidad de 439 MW (final de 2025) a 2.537 MW. El 85% de los operadores señala el acceso a la red eléctrica como su principal cuello de botella.
La respuesta del regulador
El Ministerio para la Transición Ecológica abrió en agosto de 2026 el periodo de consulta pública del «Proyecto de Real Decreto por el que se regulan los requisitos de sostenibilidad energética, medioambiental y de resiliencia y soberanía digital aplicables a los centros de datos». Es una norma que posiciona a España como uno de los reguladores más exigentes de Europa en este terreno. Afecta a toda instalación de más de 1 MW y establece, entre otros:
- Eficiencia hídrica (WUE) de Categoría A, el nivel más estricto previsto por el Reglamento Delegado UE 2024/1364, con valor provisional WUE ≤ 0,1 hasta agosto de 2027. En la práctica, descarta los sistemas evaporativos tradicionales y fuerza la refrigeración de circuito cerrado.
- Eficiencia energética (PUE) de Categoría A, con un umbral de 1,15 como máximo.
- Adicionalidad renovable del 80% hora a hora: cada hora de operación debe estar respaldada por generación renovable propia o contratada, instalada en los 18 meses previos. Es una cláusula que la propia UE no exige y que diferencia la norma española.
- Penalizaciones crecientes en cargos y peajes por incumplimiento, con revocación última de los derechos de acceso a la red eléctrica.
- Seis meses de adaptación para los proyectos en curso.
La gigafactoría de Móra la Nova encaja ya en este marco: su diseño incorpora refrigeración de circuito cerrado, con consumo de agua declarado como cercano a cero. Los sistemas convencionales habrían demandado del orden de 1,8 a 4 litros por kWh.
España aprieta las tuercas, por tanto, en el mismo momento en que capta inversión récord. Es una tensión real que marcará la viabilidad de proyectos y la geografía de los próximos despliegues.
La respuesta de la industria
Mientras el regulador aprieta por un lado, la industria responde por el otro con investigación aplicada que persigue el mismo objetivo: reducir el coste computacional por consulta. Google Research publicó en ICML 2026 un paper que ilustra bien la línea de trabajo: «Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion«, firmado por Jiang, Li y otros ocho autores.
La idea en una línea (técnica): en lugar de pedir a un modelo autoregresivo que piense cada vez que recibe una consulta compleja, se entrena una sola vez con aprendizaje por refuerzo un modelo pequeño de difusión (53,9 millones de parámetros) que resuelve la descomposición en subconsultas en una única pasada no autoregresiva. Resultado: entre 12 y 20 veces menos latencia que el enfoque convencional, con criterios formales de calidad en la respuesta.
La idea en una línea (no técnica): hoy, cuando un sistema de IA recibe una consulta compleja, «piensa en voz alta» y va soltando las subconsultas una palabra tras otra, un proceso lento y caro por diseño. El paper propone un atajo: entrenar una sola vez un modelo pequeño que, llegado el momento de responder al usuario, suelta todo el conjunto de subconsultas de una sola pasada, sin ir palabra a palabra. El resultado se entrega entre 12 y 20 veces más rápido, y con criterios de calidad definidos matemáticamente para que las subconsultas ni se solapen entre sí ni se desvíen del tema original.
Esos criterios merecen atención, porque hablan directamente al SEO semántico. El paper los articula como tres anclas que operan en tensión:
- Groundedness: cada subconsulta generada debe corresponder a un ítem real recuperable en la base de datos. Nada de inventar.
- Diversidad (medida con la métrica Vendi Score): cubrir facetas complementarias del tema, no variantes paráfrasticas de la misma idea.
- Alineación: no derivar semánticamente respecto a la intención original del usuario.
El trabajo se evalúa en el sector moda (datasets de outfits de Polyvore) y en música (playlists), no en búsqueda web abierta. Los propios autores reconocen que el coste de entrenamiento inicial puede ser sustancial cuando la base de datos cambia a menudo, lo cual atempera la aplicabilidad directa a un índice web vivo.
Pero la dirección del esfuerzo es inequívoca: la industria busca servir el fan-out más barato, más limpio y mejor anclado al corpus.
Lo que significa para quien publica contenido
Aquí es donde las dos tensiones (la del regulador apretando el coste ambiental, la de la industria apretando el coste computacional) convergen en una implicación práctica para quien trabaja con contenido en la web.
Los sistemas de recuperación bajo presión económica favorecen fuentes que cumplen tres condiciones muy concretas:
- Anclables a entidades reconocibles, descritas con vocabularios estándar (schema.org, Dublin Core, SKOS). Un contenido con una buena capa de datos estructurados en JSON-LD, con referencias cruzadas a entidades consolidadas, es más barato de recuperar y de verificar que un contenido que vive solo como texto plano.
- Organizadas en facetas limpias y complementarias, no en variantes paráfrasticas del mismo tema. Un cluster de contenido que cubre aspectos genuinamente distintos de un dominio es más valioso que doce artículos que repiten el mismo ángulo con sinónimos. Es la misma lógica del paraphrastic collapse que el paper de Google combate con la métrica Vendi.
- Mantenidas. Un dominio sin 404 colgando, con redirecciones bien mapeadas y rutas estables, consume menos recursos de rastreo y resulta más fiable como fuente. Las consecuencias globales del 404 adquieren una nueva dimensión cuando cada consulta se multiplica por N en la fase de recuperación.
Este es el territorio donde el framework del Descriptor Semántico Homogéneo (DSH) y la arquitectura de información bien pensada dejan de ser cuestión de higiene y pasan a ser cuestión de eficiencia operativa agregada.
Un sitio bien construido es un activo que reduce fricción no solo para el usuario, sino para toda la cadena de recuperación que lo atraviesa.
Otra controversia más alrededor de la IA
La discusión sobre la IA y el medio ambiente suele moverse en el terreno ético abstracto. Vale la pena bajarla al mapa. Los parques eólicos marinos del Empordà, el agua de la cuenca del Ebro, las subestaciones aragonesas y los metros cuadrados de nave industrial en la Ribera d’Ebre son el soporte físico de cada consulta con IA que lanzamos desde el navegador. La red tiene coordenadas. Nuestro trabajo con contenidos también.
El regulador español ha decidido que esas coordenadas no van a ser gratuitas, con una norma que combina exigencia de eficiencia hídrica y energética con un requisito renovable horario inédito en Europa. La industria responde con investigación que persigue hacer más con menos cómputo. Y a quien se dedica profesionalmente a estructurar y publicar contenido en la red le toca una conclusión práctica: el contenido mal organizado y mal mantenido ya no es solo invisible ni solo caro para el propio editor.
Es trabajo computacional estéril que se multiplica por N y aterriza en algún sitio con nombre.
Un buen trabajo semántico, con entidades sólidas, facetas limpias y arquitecturas estables, no mejora solo el posicionamiento. Reduce la factura agregada del sistema, incluida la factura territorial.
Debate público: El precio de la transición digital y energética en el territorio
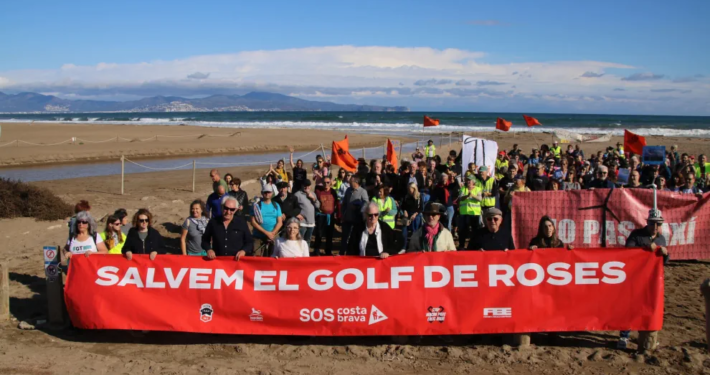
La optimización del coste computacional y la proliferación de centros de datos en Cataluña abren un dilema irresuelto sobre su coste territorial. La cara visible de esta tensión se vive en el golfo de Roses (Alt Empordà), donde la Plataforma Stop Macroparc Eòlic Marí encabeza una fuerte oposición vecinal, ecologista y pesquera contra los macroproyectos de energía eólica marina.
Mientras la Economía de Búsqueda y las infraestructuras digitales requieren un suministro eléctrico masivo y verde para reducir sus emisiones, el territorio se rebela frente a un modelo energético centralizado que amenaza la biodiversidad marina y el impacto paisajístico de la Costa Brava.
Este escenario traslada una pregunta incómoda al corazón de la sostenibilidad tecnológica:
¿Es lícito descarbonizar la nube a costa de sacrificar ecosistemas y economías locales?
El debate entre eficiencia de computación y soberanía del territorio está más abierto que nunca.
Fuentes
- Google Research: Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train. https://research.google/blog/bypassing-inference-bottlenecks-accelerating-complex-ai-search-with-retrieve-for-train/
- Jiang, Li et al.: Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion, arXiv 2603.06397 (ICML 2026). https://arxiv.org/abs/2603.06397
- Google: AI Mode in Google Search, Updates from Google I/O 2025. https://blog.google/products-and-platforms/products/search/google-search-ai-mode-update/
- Google Cloud: Measuring the environmental impact of AI inference. https://cloud.google.com/blog/products/infrastructure/measuring-the-environmental-impact-of-ai-inference – Google: Informe ambiental 2026. https://blog.google/company-news/outreach-and-initiatives/sustainability/2026-environmental-report/
- IEA: Energy and AI – Energy demand from AI. https://www.iea.org/reports/energy-and-ai/energy-demand-from-ai
- MITECO: Comunicado de 27 de agosto de 2026 sobre el proyecto de Real Decreto de centros de datos sostenibles. https://www.miteco.gob.es/es/prensa/ultimas-noticias/2026/agosto/-el-gobierno-plantea-impulsar-los-centros-de-datos-sostenibles–.html
- Diari de Tarragona: La gigafactoria d’IA de Mora la Nova consumirá un agua cercana a cero, 1 de julio de 2026. https://www.diaridetarragona.com/economia/264630/gigafactoria-ia-mora-nova-consumira-agua.html
- Público: ¿Hay agua en la piscina de los centros de datos que impulsa el PP en Aragón?, febrero de 2026. https://www.publico.es/politica/hay-agua-piscina-centros-datos-impulsa-pp-aragon.html
- Ara: Luz verde al proyecto Plemcat de molinos marinos flotantes en el Empordà, 23 de junio de 2026. https://es.ara.cat/economia/energia/luz-verde-proyecto-generalitat-poner-molinos-mar-emporda_1_5777882.html
- SpainDC: Informe anual del sector 2025 (publicado por BrainsRE, marzo de 2026). https://brainsre.news/centros-datos-movilizaran-66900-millones-espana-2030/
 © Ricard Menor SOLID SEO - Experto en Datos Estructurados & Linked-Data